ماتریس درهم ریختگی یا Confusion Matrix چیست؟ | بیان ساده
ماتریس درهم ریختگی یا همان Confusion Matrix یک جدول است که برای ارزیابی عملکرد مدلهای طبقهبندی استفاده میشود. کاربرد این ماتریس این است که پیشبینیهایی که مدل انجام داده را با نتایج واقعی مقایسه میکند تا مشخص شود کدام پیشبینیها درست یا اشتباه بودهاند.
وقتی ماتریس درهم ریختگی را بررسی کنید، میتوانید اجزایی مانند TP، TN، FP و FN و معیارهایی مانندAccuracy ،Precision ، Recall و F1-Score را بشناسید و عملکرد مدلتان را دقیقتر و بهتر تحلیل کنید.
ماتریس درهم ریختگی جدولی برای ارزیابی عملکرد مدلهای طبقهبندی در یادگیری ماشین است. کاربرد این ماتریکس این است که پیشبینیهای مدل را با نتایج واقعیِ مجموعهی دادههایمان مقایسه میکند.
در واقع کاری که این ماتریس میکند این است که تعداد نمونههای واقعیِ هر کلاس را در برابرِ تعداد نمونههایی که مدل برای هر کلاس پیشبینی کرده است، میگذارد تا با هم مقایسهشان کند. به این ترتیب مشخص میشود که کدام پیشبینیهای مدل درست یا اشتباه بودهاند. به همین دلیل به آن «ماتریس خطا» (Error Matrix) هم میگویند.
یکی از اصلیترین روشهای ارزیابی عملکرد مدلهای طبقهبندی، ساختنِ ماتریس درهم ریختگی است. چون میتوانیم از اطلاعاتی که در آن وجود دارد، برای محاسبه معیارهای مهمی مانند Precision و Recall استفاده کنیم. این ابزار برای انواع الگوریتمهای طبقهبندی مانند Naïve Bayes، رگرسیون لجستیک و درخت تصمیم کارایی دارد و کتابخانههایی مانند scikit-learn در پایتون هم بسیار راحت این قابلیت را در اختیارمان میگذارند.
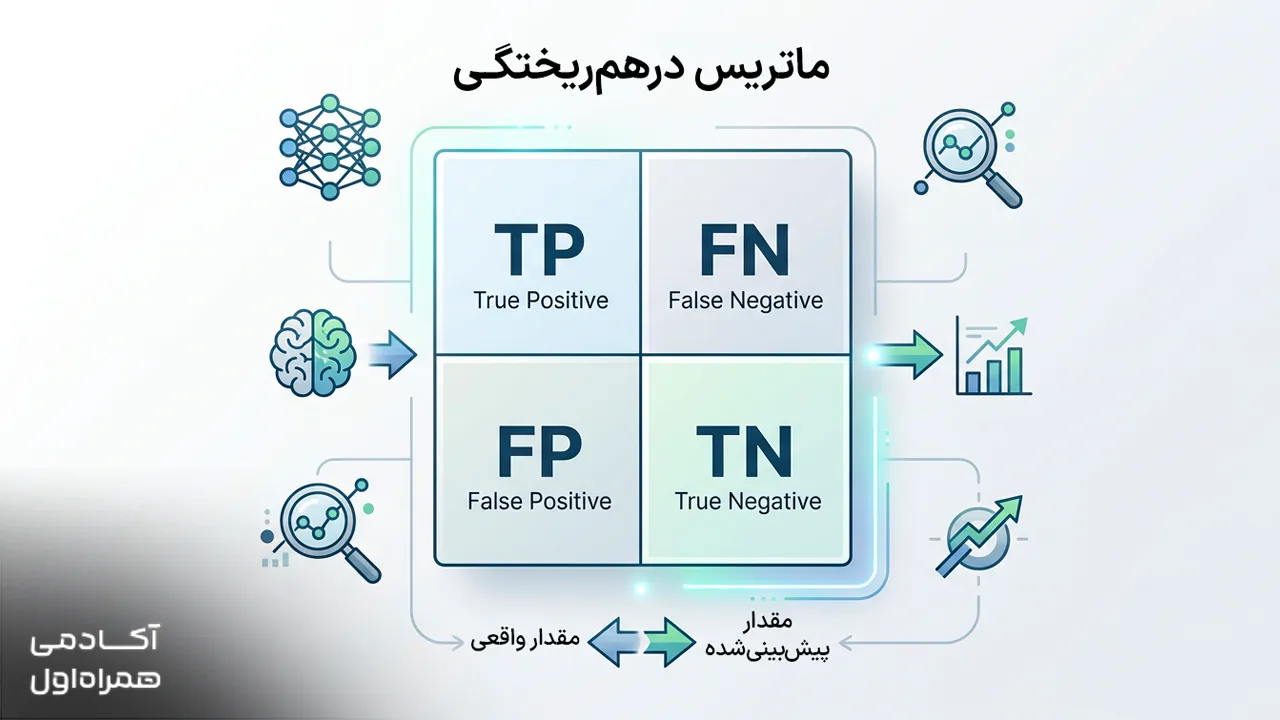
اجرای ماتریس درهم ریختگی شامل چهار بخش است که پیشبینیهای مدل را به چهار دسته تقسیم میکند:
True Positive (TP)
مثبتِ درست (TP) زمانی است که مدل نتیجه مثبت را بهدرستی پیشبینی کرده و نتیجه واقعی نیز مثبت بوده است.
True Negative (TN)
منفیِ درست (TN) زمانی است که مدل نتیجه منفی را بهدرستی پیشبینی کرده و نتیجه واقعی نیز منفی بوده است.
False Positive (FP)
مثبتِ کاذب (FP) زمانی است که مدل بهاشتباه نتیجه مثبت را پیشبینی کرده، درحالیکه نتیجه واقعی منفی بوده است. به این خطا خطای نوع اول (Type I Error) نیز گفته میشود.
False Negative (FN)
منفیِ کاذب (FN) زمانی است که مدل بهاشتباه نتیجه منفی را پیشبینی کرده، درحالیکه نتیجه واقعی در واقع مثبت بوده است. به این خطا خطای نوع دوم (Type II Error) هم گفته میشود.
نتیجه واقعی
پیشبینی مثبت
پیشبینی منفی
مثبت واقعی
مثبتِ درست (TP)
منفیِ کاذب (FN)
منفی واقعی
مثبتِ کاذب (FP)
منفیِ درست (TN)
ماتریس درهم ریختگی چگونه خوانده میشود؟
در یک ماتریس درهم ریختگی، ستونها نشاندهنده مقادیر پیشبینیشده برای هر کلاس هستند و سطرها مقادیر واقعیِ همان کلاس را نشان میدهند. البته توجه داشته باشید که در بعضی مقالهها و پژوهشها ممکن است جای سطرها و ستونها برعکس باشد.
خانههایی که روی قطر اصلی ماتریس قرار دارند، همان پیشبینیهای درستِ مدل برای هر کلاس هستند. بقیه خانههای ماتریس هم به ما نشان میدهند که مدل دقیقا کجاها کلاسها را درست تشخیص نداده و نمونهها را اشتباهی به کلاس دیگری نسبت داده است.
معیارهای ارزیابی بر اساس ماتریس درهم ریختگی
ماتریس درهم ریختگی نتایج پیشبینی مدل طبقهبندی را به ما نمایش میدهد و میتوان از مقادیری که در آن وجود دارد، برای محاسبه معیارهای مختلف ارزیابی مدل استفاده کرد. مثلا Accuracy ،Precision ،Recall و F1-Score از معیارهایی هستند که با استفاده از همین مقادیر محاسبه میشوند.
Accuracy
معیار Accuracy به ما نشان میدهد که مدل چند درصد از پیشبینیهایش را درست انجام داده است. این معیار دیدِ کلی از عملکرد مدل میدهد، ولی اگر تعداد نمونههای کلاسها با هم تفاوت زیادی داشته باشند (نامتوازن باشند)، Accuracy ممکنه گمراهکننده باشد.
مثلا فرض کنید مدل اکثر نمونههای یک کلاسِ پرتعداد را درست حدس میزند، در این صورت Accuracy بالایی میگیرد، اما ممکن است نتواند نمونههای کلاس دیگر را درست تشخیص دهد. برای همین، Accuracy بهتنهایی معیار کاملی برای ارزیابی مدلهای طبقهبندی نیست.
فرمول Accuracy:
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Precision
معیار Precision نشان میدهد از بین تمام مواردی که مدل برای یک کلاس خاص پیشبینی کرده است، چندتایشان واقعا متعلق به آن کلاس بودهاند. به این معیار «ارزش پیشبینی مثبت» (Positive Predictive Value یا همان PPV) هم میگویند.
Precision وقتی اهمیت زیادی پیدا میکند که کاهش مثبتهای کاذب (FP) مهم باشد. یعنی میخواهیم مواردِ مثبتِ کاذب یا همان FP را تا جای ممکن کم کنیم. مثلا در تشخیص ایمیلهای هرز یا سیستمهای شناسایی تقلب، Precision نقش کلیدی دارد.
فرمول Precision:
Precision = TP / (TP + FP)
Recall
Recall معیاری است که به ما میگوید مدل چه نسبتی از نمونههای واقعیِ یک کلاس را توانسته درست شناسایی کند. به این معیار، «حساسیت» (Sensitivity) یا «نرخ مثبت واقعی» (True Positive Rate یا TPR) هم گفته میشود.
نقش Recall زمانی مهم میشود که از دست دادنِ نمونههای مثبت، پیامدهای خیلی بد داشته باشد. به فرض مثال در تستهای پزشکی اصلا نمیخواهیم یک بیمار را اشتباهی سالم تشخیص دهیم.
فرمول Recall:
Recall = TP / (TP + FN)
F1-Score
معیار F1-Score کاری که میکند این است که Precision و Recall را با هم ترکیب میکند تا بین این دو معیار، تعادل منطقی برقرار شود. این معیار مخصوصا در مواقعی کاربرد دارد که مجموعهدادههایمان نامتوازن باشد و تعداد نمونههای کلاسها در آن برابر نباشد.
به خاطر داشته باشید که وقتی میخواهیم Recall را بالا ببریم، ممکن است مدل بعضی نمونههایی را که به یک کلاس تعلق ندارند، به اشتباه در همان کلاس قرار دهد. این مثبتهای کاذب (FP) میتوانند باعث کاهش Precision شوند. F1-Score با ترکیب Precision و Recall، دید کلیتری از عملکرد مدل ارائه میدهد.
F1-Score با نامهای F-Score و F-Measure شناخته میشود و میانگین هارمونیک Precision و Recall است.
یادگیری علم داده به شما کمک میکند که بتوانید دادهها را تحلیل کنید، الگوهای پنهان در آنها را شناسایی و از این نتایج برای تصمیمگیریهای بهتر استفاده کنید. مفاهیمی مانند «ماتریس درهم ریختگی» هم دقیقا در همین مسیر یادگیری ماشین قرار دارند و برای ارزیابی مدلهای طبقهبندی بهکار میروند. در واقع، یاد گرفتن این مهارتها میتواند راهتان را برای ورود به حوزههایی نظیرِ تحلیلگری داده، مهندسی داده و علم داده باز کند.
آکادمی همراه اول برای یادگیری علم داده، ۳ مسیر شامل «دانشمند داده»، «مهندس داده» و «تحلیلگر داده» را طراحی کرده است که در مجموع ۳۰ دوره هستند. اگر تازه میخواهید وارد این حوزه شوید، دوره «آشنایی با مبانی علوم داده» دورهای مقدماتی و بدون پیشنیاز است که میتواند شروع خوبی برای آشنایی با این حوزه باشد.
اگر میخواهید یادگیری علم داده را از مباحث پایه شروع کنید، پیشنهاد میکنیم این مسیر یادگیری را با دانلود آموزشهای زیر شروع کنید:
فرض کنید یک مدل برای تشخیص تصویر «سگ» یا «غیرسگ» استفاده میشود. در این مثال، ۱۰ تصویر بررسی شده است:
شماره
نتیجه واقعی
پیش بینی مدل
نتیجه
۱
سگ
سگ
TP
۲
سگ
غیرسگ
FN
۳
سگ
سگ
TP
۴
غیرسگ
غیرسگ
TN
۵
سگ
سگ
TP
۶
غیرسگ
سگ
FP
۷
سگ
سگ
TP
۸
سگ
سگ
TP
۹
غیرسگ
غیرسگ
TN
۱۰
غیرسگ
غیرسگ
TN
نتایج این مثال:
تعداد واقعی تصاویر سگ: ۶
تعداد واقعی تصاویر غیرسگ: ۴
True Positive (TP): ۵
False Positive (FP): ۱
True Negative (TN): ۳
False Negative (FN): ۱
در نتیجه، ماتریس نهایی به این شکل است:
واقعیت
پیشبینی: سگ
پیشبینی: غیرسگ
سگ
TP = ۵
FN = ۱
سگ
FP = ۱
TN = ۳
پیوند یکتا: confusion-matrix نام فایل: confusion-matrix.png متن جایگزین: نمایش ماتریس درهمریختگی برای تشخیص سگ و غیرسگ با مقادیر TP، TN، FP و FN
در این ماتریس، سطرها نتیجه واقعی و ستونها پیشبینی مدل را نشان میدهند. در قطر اصلی، پیشبینیهای درست قرار دارند. یعنی ۵ مورد سگ که بهدرستی سگ تشخیص داده شدهاند (TP) و ۳ مورد غیرسگ که بهدرستی غیرسگ تشخیص داده شدهاند (TN). دو خانه دیگر، پیشبینیهای اشتباه را نشان میدهند، یعنی ۱ مورد سگ که غیرسگ پیشبینی شده است (FN) و ۱ مورد غیرسگ که سگ پیشبینی شده است (FP).
محدودیتهای ماتریس درهم ریختگی
یکی از محدودیتهایی که میتوانیم به آن اشاره کنیم، مربوط به معیار Accuracy است. همانطور که پیشتر هم اشاره کردیم، این معیار بهتنهایی معیار کاملی برای ارزیابی مدلهای طبقهبندی نیست. چون زمانی که تعداد نمونههای کلاسها تفاوت زیادی داشته باشد، Accuracy ممکن است گمراهکننده باشد.
مثلا فرض کنید مدلی بیشتر نمونههای یک کلاس پرتعداد را بهدرستی پیشبینی میکند. این مدل ممکن است Accuracy بالایی داشته باشد، اما در تشخیص نمونههای کلاس دیگر عملکرد مناسبی نداشته باشد.
دومین محدودیت هم مربوط به F1-Score است. چون F1-Score به Precision و Recall وزن یکسانی میدهد، درحالیکه این دو معیار ممکن است در همه مجموعهدادهها اهمیت یکسانی نداشته باشند. بهعنوان راهحل، میتوان از انواع اصلاحشده F1-Score استفاده کرد.
نتیجهگیری
ماتریس درهمریختگی یکی از روشهای ارزیابی مدلهای طبقهبندی است که پیشبینیهای درست و نادرست مدل را به ما نشان میدهد.
ما از مقادیر همین ماتریس استفاده میکنیم تا معیارهای کلیدی ارزیابی مثل Accuracy ،Precision ،Recall و F1-Score را حساب کنیم. البته این ماتریس فقط محدود به مسائلِ دو کلاسه نیست. ماتریس درهم ریختگی را میتوان در مسائل طبقهبندی دودویی و چندکلاسه نیز استفاده کرد.
مطالعه پاسخ پرسشهای متداول کمکتان میکند تا دید روشنتر نسبت به موضوع پیدا کنید. علاوهبراین پیشنهاد میکنیم شما هم نظرات و سوالاتتان را در بخش دیدگاهها با ما به اشتراک بگذارید.
۱- ماتریس درهمریختگی چیست؟
ماتریس درهم ریختگی یک جدول است که برای ارزیابی عملکرد مدلهای طبقهبندی از آن استفاده میشود. کار این ماتریکس این است که نتایج واقعی یک مجموعهداده را با پیشبینیهای مدل مقایسه میکند و پیشبینیهای درست و نادرست را نشان میدهد.
۲- چهار جزء اصلی Confusion Matrix کداماند؟
چهار جزء اصلی ماتریس درهم ریختگی شامل True Positive (TP) یا مثبتِ درست، True Negative (TN) یا منفیِ درست، False Positive (FP) یا مثبتِ کاذب و False Negative (FN) یا منفیِ کاذب هستند.
۳- تفاوت Precision و Recall چیست؟
Precision نشان میدهد چه نسبتی از نمونههایی که مدل برای یک کلاس پیشبینی کرده، واقعا به همان کلاس تعلق دارند. اما Recall به ما میگوید که مدل چه نسبتی از نمونههای واقعی یک کلاس را توانسته شناسایی کند.
۴- ماتریس درهمریختگی چه کاربردی دارد؟
اصلیترین کاربرد ماتریس درهم ریختگی، همان ارزیابی عملکرد مدلهای طبقهبندی است. میتوان از مقادیری که در آن وجود دارد برای محاسبه معیارهایی مانند Accuracy ،Precision ،Recall و F1-Score استفاده کرد.
۵- آیا Confusion Matrix فقط برای مسائل طبقهبندی استفاده میشود؟
ماتریس درهم ریختگی ابزاری برای مسائل طبقهبندی است و در در طبقهبندی دودویی و هم در طبقهبندی چندکلاسه خیلی خوب جواب میدهد و میتوانید از آن استفاده کنید.



 ۷۹۱۲ نفر
 ۱۶۰ ساعت و ۲۹ دقیقه